Projeto · 2023–2026
Plataforma de Dados & Marketing Analytics
Plataforma de dados que desenhei e opero em produção no Microsoft Fabric — 137 itens, lakehouse medallion e star schema de 133 tabelas alimentados por PySpark a partir de 9+ fontes, do clique no anúncio à conversão.
Dado espalhado por nove sistemas só vira decisão quando alguém o traz para um lugar só, no formato certo e no tempo certo. Foi essa a plataforma que construí: um lakehouse medallion que transforma origens cruas em modelos que a diretoria lê no Power BI.
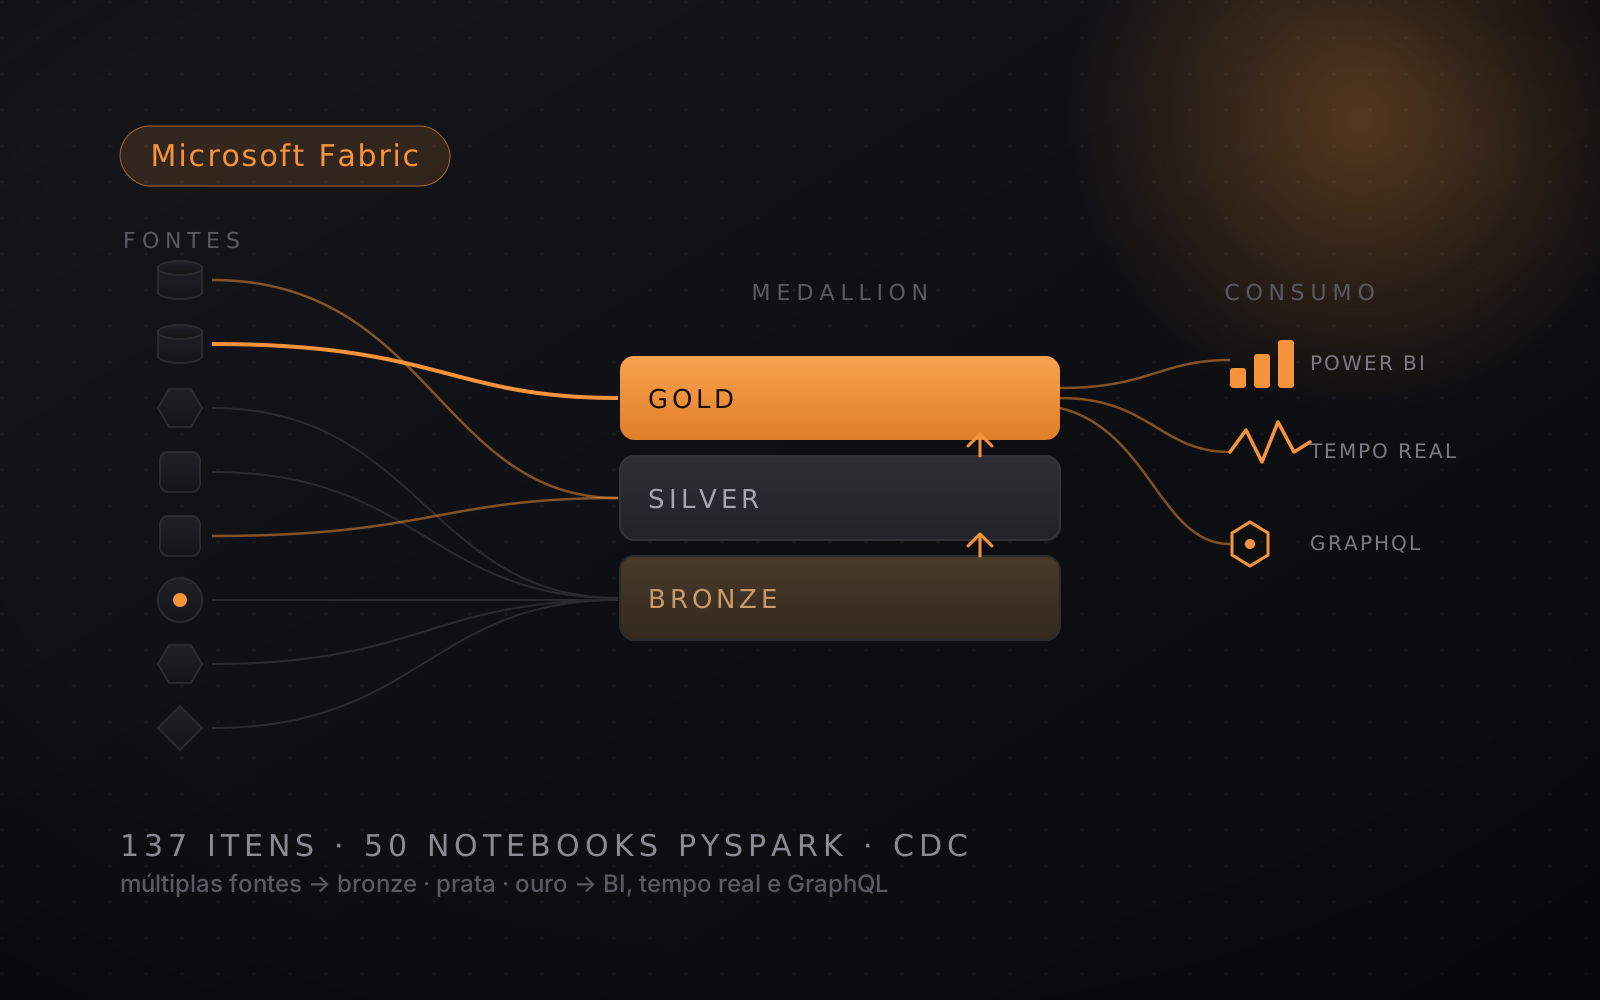
Desenhei e opero, de ponta a ponta, uma plataforma de dados em produção no Microsoft Fabric para uma grande organização — 137 itens publicados no workspace de produção: 52 dataflows, 50 notebooks PySpark, 21 pipelines, 6 lakehouses, 4 warehouses, um Eventhouse de tempo real e uma API GraphQL.
O coração é um lakehouse em arquitetura medallion (bronze/silver/gold): a ingestão em PySpark traz e sanitiza dados de 9+ fontes heterogêneas — o Oracle acadêmico e o ERP corporativo on-premises, as APIs de anúncios (Meta e Google Ads), ferramentas de CRM e automação de marketing, currículos Lattes/CNPq e microdados regulatórios (ENADE/INEP). Da camada ouro nascem 133 tabelas modeladas em star schema, dimensões e fatos, unindo o mundo acadêmico e o corporativo.
Ingestão incremental de verdade: em vez de recarregar tudo a cada rodada, os pipelines capturam só o que mudou — e ainda rastreiam exclusões (CDC sobre o Oracle). O custo de processamento acompanha o delta, não o tamanho da base; é o que faz uma plataforma desse porte caber no orçamento e rodar todo dia.
Funil de marketing analytics completo — do clique no anúncio à conversão — com CPC, CAC e ROAS calculados sobre os dados de mídia num ciclo diário, e integração ao WhatsApp via API: o dado sai do lakehouse e volta como ação comercial.
Analytics em tempo real com Eventhouse/KQL, modelos semânticos com refresh orquestrado por pipeline, Power BI (inclusive Embedded) e dados servidos por API GraphQL. Tudo versionado em Git com pipelines de deploy (DataOps) e ambientes separados no tenant — produção, desenvolvimento, simulação e um cockpit executivo —, mais o gateway on-premises e o licenciamento Azure/Fabric que eu configuro e mantenho.
Em números
- 137
- Itens em produção
- 133
- Tabelas em star schema
- 9+
- Fontes integradas
- 52
- Dataflows
- 50
- Notebooks PySpark
- 21
- Pipelines orquestrados
- 6
- Lakehouses
- 8
- Workspaces no tenant
- 3
- Anos em produção
- 24h
- Ciclo dos dados de mídia
Decisões de engenharia
- 01
Medallion de ponta a ponta
Escolhi separar o dado cru do dado confiável em camadas: bronze recebe a origem como ela é, silver limpa e concilia, gold entrega o modelo pronto para consumo. Cada camada tem uma responsabilidade única, então um erro de origem não contamina o dashboard — e dá para reprocessar do ponto certo sem refazer tudo.
- 02
Ingestão incremental com CDC sobre Oracle
Recarregar a base inteira todo dia seria caro e lento. Os pipelines capturam só o que mudou desde a última carga e rastreiam também as exclusões (CDC), para o lakehouse não guardar registro que já morreu na origem. O custo de processamento passa a acompanhar o volume de mudança, não o tamanho total da base.
- 03
Dois mundos num mesmo star schema
O acadêmico (alunos, contratos, cursos, censo) e o corporativo (folha, contabilidade, orçamento, compras) falam línguas diferentes. Modelei 133 tabelas em dimensões e fatos que conformam essas origens — mesma noção de tempo, de curso, de centro de custo — para que uma pergunta cruze matrícula e receita sem gambiarra.
- 04
Do clique à conversão
O funil junta a mídia paga (Meta e Google Ads) com o CRM e a matrícula, e calcula CPC, CAC e ROAS num ciclo diário — quanto custou o clique, quanto custou o aluno, quanto o anúncio retornou. E fecha o laço: o dado sai do lakehouse e volta como mensagem no WhatsApp, virando ação comercial em vez de só relatório.
- 05
Consumo além do dashboard
Nem todo consumidor de dado é uma tela. Além do Power BI (inclusive Embedded), a plataforma serve analytics em tempo real por Eventhouse/KQL e expõe dados por uma API GraphQL — o mesmo lakehouse alimentando dashboards, sistemas e consultas ad-hoc pela via mais adequada a cada um.
- 06
DataOps: a plataforma tratada como software
Tudo vive em Git com pipelines de deploy e ambientes separados no tenant — produção, desenvolvimento, simulação e um cockpit executivo. Configurei o gateway on-premises que liga a nuvem aos bancos internos e cuido do licenciamento Azure/Fabric. Não é um amontoado de notebooks: é uma plataforma versionada, promovível e operável.
Arquitetura
Fontes
9+ origens heterogêneas
Oracle acadêmico e ERP corporativo on-prem, APIs de anúncios, CRM/marketing e dados regulatórios.
Ingestão PySpark
Bronze, incremental
50 notebooks e 52 dataflows; carga só do delta e rastreio de exclusões (CDC).
Medallion
Bronze → silver → gold
Sanitização e conciliação camada a camada até o modelo pronto para consumo.
Lakehouse
OneLake · star schema
6 lakehouses; 133 tabelas dim/fact unindo o acadêmico e o corporativo.
Orquestração
21 pipelines
Dependências, agendamento e refresh dos modelos semânticos.
Marketing funnel
Clique → conversão
CPC, CAC e ROAS em ciclo diário; ação de volta no WhatsApp.
Consumo
Power BI · KQL · GraphQL
Dashboards e Embedded, tempo real por Eventhouse e API GraphQL.
DataOps
Git · deploy · gateway
Versionamento, pipelines de deploy, ambientes separados e gateway on-prem.
Stack